はじめに
最近はやりのMoEモデルでも重みをVRAMに乗せる必要があり、巨大なモデルは普通のグラボでは実行できませんでした。
Strataというツールは、モデル全体をVRAMに読み込ませず、よく使うExpertやKV、AttentionはVRAM、それ以外のExpertはRAMに配置してCPUで演算するらしい。これにより、Qwen3.8-Flash-NextのようなモデルもゲーミングPCで実行可能とのことです。
Strataのセットアップ
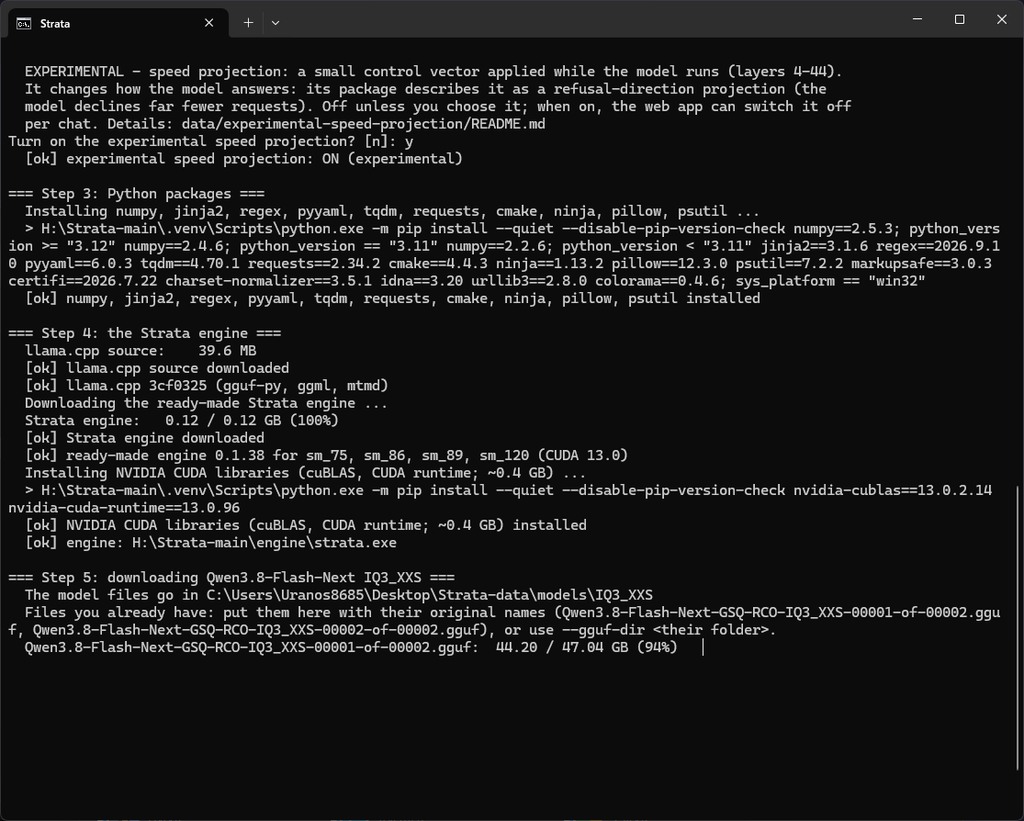
Strataは以下で配布されている。Strata-main.zipをダウンロードし、解凍してSTART-HERE.batを実行してください。
GitHub – Niko1221/Strata: Qwen3.8-Flash-Next on any consumer hardware: one-click install for Windows / Linux. Strata inference engine, OpenAI/Anthropic API on localhost, optional image input.
Qwen3.8-Flash-Next on any consumer hardware: one-click install for Windows / Linux. Strata inference engine, OpenAI/Anth…
github.com
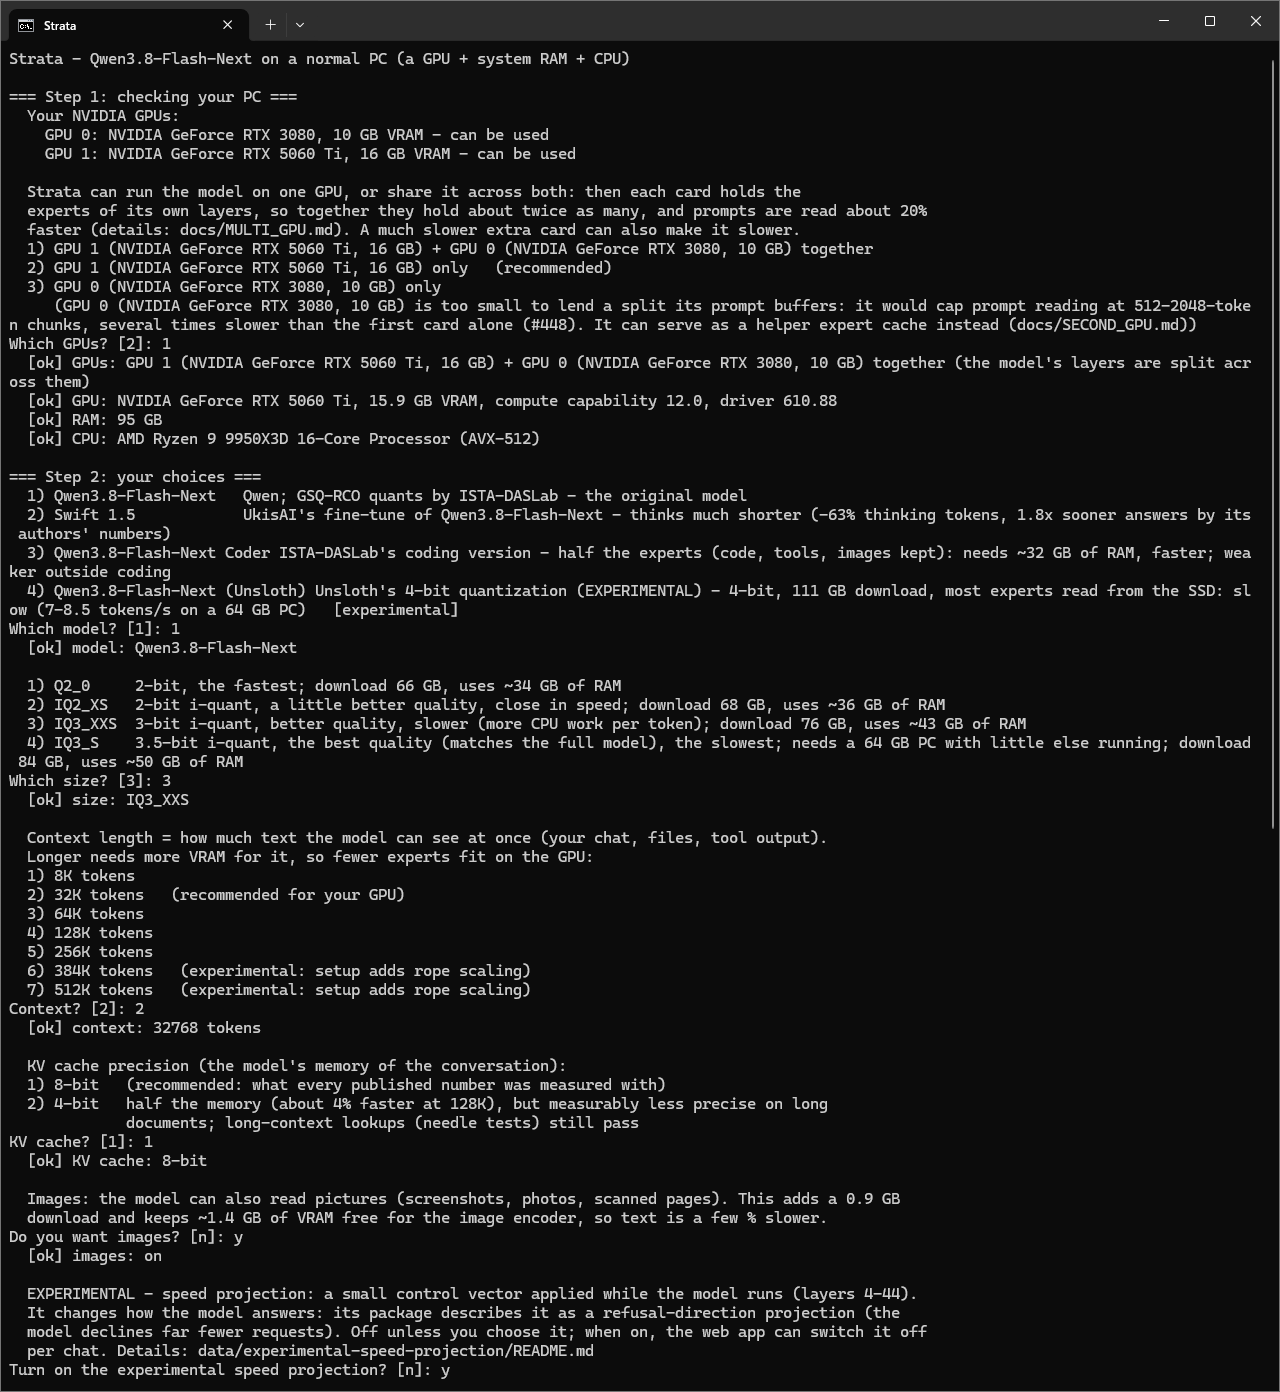
すると、利用可能なグラボが表示されるので、どのグラボを使うか、どのモデルをダウンロードするかといった質問に対して回答していけばOK。
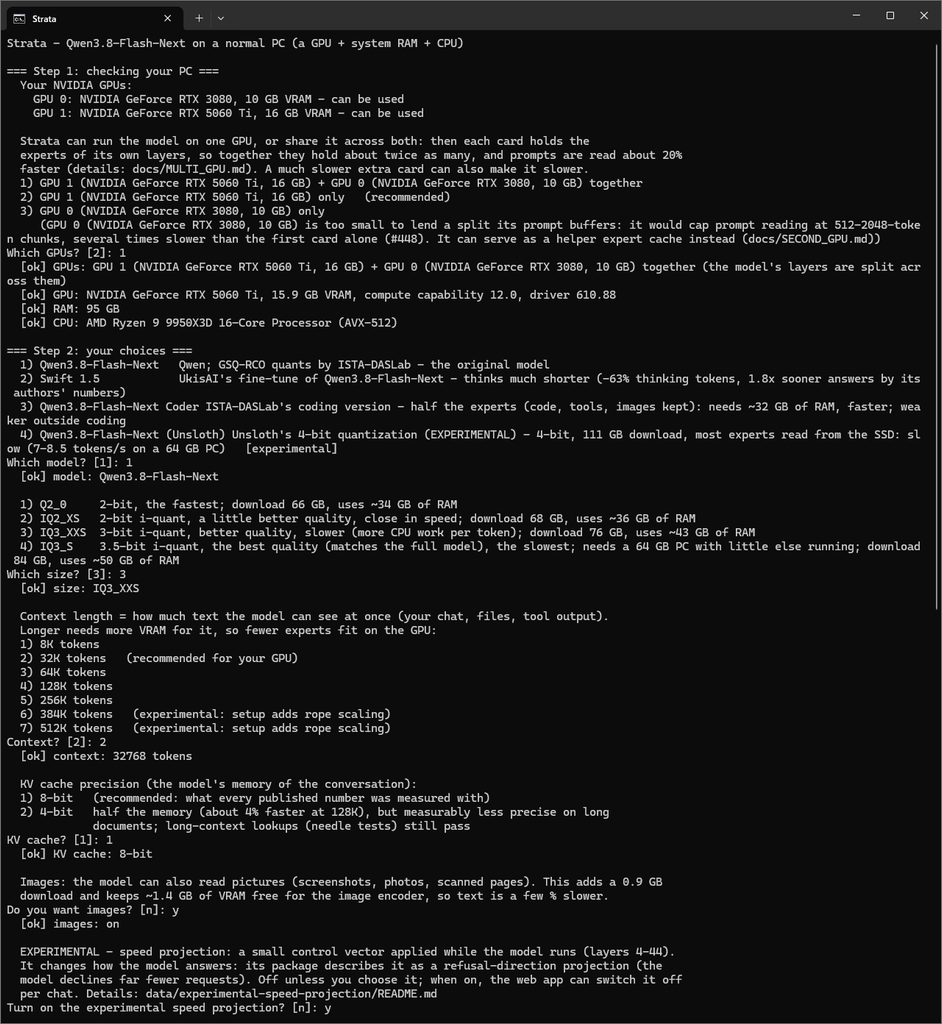
Q2のモデルでもRAMを34GB使うらしいので、最低でも48GBのRAMがないと厳しそう。今のご時世的に、なかなかハードルが高いかもしれない…。
デモ
テスト環境は以下のとおり。
| 項目 | 内容 |
|---|---|
| CPU | Ryzen9 9950X3D |
| RAM | 96GB(DDR5,3600MT/S) ※2種類のモジュールを入れてるキメラなので遅い… |
| GPU | 5060tiと3080の2枚差し(5060tiのみを使用) |
40~60token/s程度の速度が出ていていい感じ。ちなみに、3080と5060tiを使う設定でも試したが、3080が足を引っ張って5060ti単品よりも遅かった。
OpenAI,Anthropic互換API持っているそうで、Pythonから叩くこともできるんだって。いいですね~。
MoEモデルが出てきたときに、使わない部分はRAMに逃がせないかなーと思っていましたが、ついにその夢を叶えてくれるアプリが出てきてうれしいです。
おわり。
コメント